データ化学工学研究室物語
第Ⅱ部 高精度モデルの落とし穴
学部四年生から修士課程へ。実際の研究で調べ、試し、考え、自分の問いを育てていく。
第5章 増えた列、減った行
連休が明けるころ、遥の机には、二枚だった工程の図が何枚も重なっていた。
膜Aと膜Bの図は、一番上にある。
同じ 80 ℃でも、乾燥の条件なのか、その後の処理の条件なのかが違った。時間と雰囲気も同じではなかった。
その違いを、ほかの膜にも使える入力にする。
前の報告会で自分から提案したことだったが、二つの図に線を引くことと、72 個の記録を同じ規則で整理することの間には、思っていたより距離があった。
一つの論文を読むたびに、少し違う書き方が現れる。
工程が続けて書かれているもの。温度だけが本文にあり、時間は補足資料にあるもの。同じ操作を、途中で条件を変えて繰り返しているもの。
表の列は増えた。
その列を最後まで埋められる行は、なかなか増えなかった。
前の週、先生に紹介してもらい、膜を作る実験を担当している大学院生に、工程の図を見てもらった。
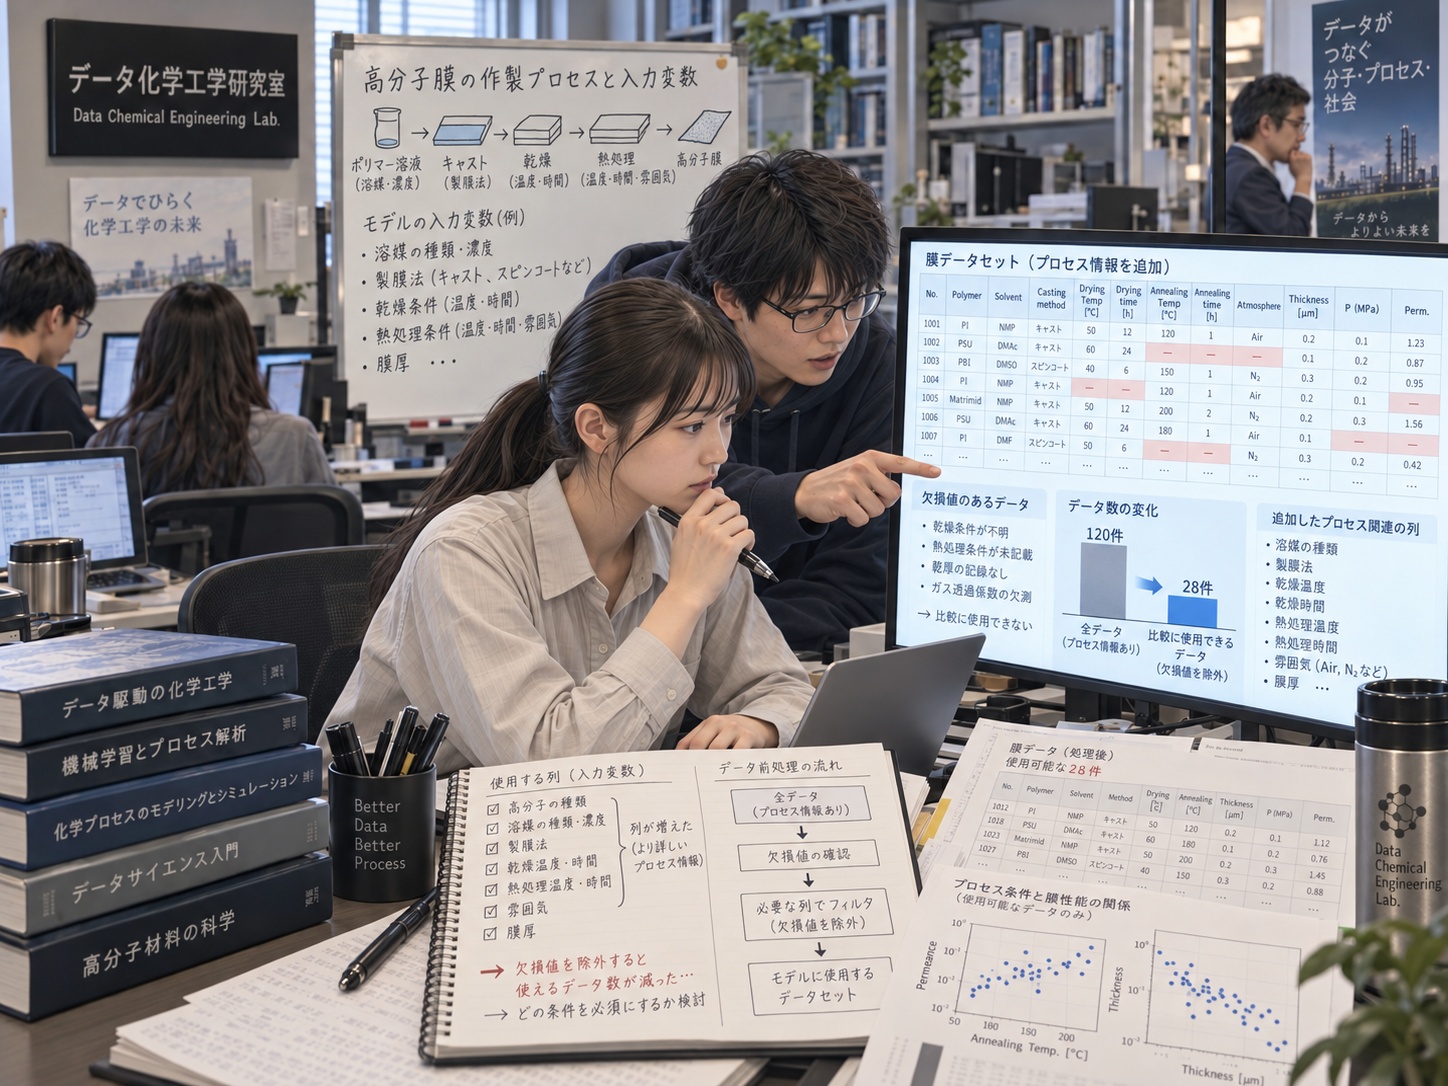
打ち合わせ用の机に、遥と紺色のパーカーの先輩も座った。大きな画面へ映したのは、原著論文の記載と、自分で整理した二本の手順だった。
「この矢印のところでは、膜を基板からはがしていますか」
大学院生に聞かれ、遥は、工程の表を下へたどった。
「この記録では、はがす時点までは確認できていません」
「それなら、ここは空けておいて大丈夫です。ただ、実際に作り方を相談するときには、同じ膜を想像しているか確かめたい場所ですね」
遥は、図の小さな四角を見た。
溶液を広げる。乾燥する。処理する。
短い名前を付けると、操作を説明できたように感じていた。実験をする人が見ると、その名前の間にも、確認したいことがあるらしかった。
大学院生は、膜Aと膜Bの温度を順に指した。
「この二つでは、どこに温度が書かれているかを分けたのは分かります。ただ、乾燥が終わって、そこから別の現象が始まったと確認した図ではないですね」
「はい。原著論文に書かれた操作の順番として整理しました。溶媒が完全になくなった時点を測ったわけではありません」
「その説明も、図と一緒に残しておくとよいと思います」
先輩が、今考えている入力の候補を見せた。
構造記述子に加え、乾燥と、それに続く処理の温度、時間、雰囲気を分けて使う。まずは、その形に対応させられる記録で比べる案だった。
「すべての膜の作り方を、この二つの箱に入れるんですか」
遥は首を横に振った。
「繰り返しや、別の順番がある手順は、元の工程表に残します。今の二段階の形では表し切れないものを、無理に押し込まないつもりです」
「それなら、今回のモデルが扱う作り方の範囲も、説明できますね」
相談を終えて席へ戻ると、遥は「入力に使う項目」と「記録には残すが、今回の入力にはしない項目」を分けた。
基板からはがす時点、保管の時間、原文の操作名。それぞれを確かめる場所は残す。ただし、今週中にすべてを機械学習へ入れるとは決めなかった。
分かった情報を保存することと、最初の比較で使う情報を決めることも、別の仕事だった。
その後、先輩にも迷った箇所を見てもらいながら、同じ項目で 72 個の報告結果の照合を進めた。
予測誤差が大きかった記録だけでなく、小さかった記録も、順に確認する。報告値の大小で、工程の分類を変えることはしなかった。
最初に、今回考えた二段階の形へ対応させられないと確認した 8 行を分けた。途中で別の操作を挟むものや、処理が繰り返されるものが含まれていた。
残る 64 行のうち、入力に必要とした条件の一部を確認できなかった記録が 20 行あった。
温度が「室温」とだけ書かれている。時間の記載が見つからない。乾燥後の処理を行ったかどうか、判断できない。
それらを、物性値を見て都合よく残したり外したりはしない。
今回の数値と区分を、定義どおりに用意できたのは、44 行だった。
72 個の報告結果。
今回の簡略な工程表現には対応させない記録:8 個。
残る記録のうち、必要な条件を確認できない記録:20 個。
最初の比較に使う記録:44 個。
遥は、三つの区分を合わせて 72 になることを確認した。二つ以上の理由がある行についても、最初に工程の形を確認する順序で分類し、同じ行を二度数えないようにした。
44 行に含まれる構造グループは、20 個だった。前の 72 行にあった 30 個すべてが残ったわけではない。
記録を整理して、情報が増えた。
それなのに、最初の比較に使える範囲は狭くなった。
「また、減っちゃった」
小さく口にすると、隣の同期が顔を上げた。
「今度も重複?」
「今回は違う。新しく使いたい条件が、全部は書かれていないから」
「平均で埋めれば、全部使えるんじゃない?」
遥は、未記載の欄を見た。
値を補ってモデルへ渡す方法は、考えられる。けれど、そもそもその工程を行ったか分からない欄に、平均の温度を置くだけでよいだろうか。
「補う方法を試すとしても、何が分からないかを残したまま考えたい。まず今回は、推測で埋めない比較にする」
「少ない方が正しいってこと?」
「少なければ正しい、でもないと思う。詳しく書かれた記録だけが残るから、今回使う材料や工程にも偏りがあるかもしれない」
遥は、72 行と 44 行について、構造の内訳と透過係数の分布を並べた。
全体から、同じ割合ずつ残った形ではなかった。
だから、この 44 行で得る結果を、元の 72 行すべてや、あらゆる膜の作り方に対する結果とは呼べない。
もっと意外だったのは、残らなかった記録の名前だった。
膜A。
膜B。
今回の検討のきっかけになった、二つの膜である。
膜Aには、独立した後処理の実施を確かめられない箇所がある。膜Bでは、室温で溶媒を蒸発させた時間を確認できていなかった。
工程の違いは見つけた。
しかし、自分が最初に決めた入力を、二つとも完全に用意できたわけではなかった。
遥は、二つの行だけを例外として残したくなった。
この二つをうまく予測するために、調べ始めたのではなかっただろうか。
しばらく考えてから、ノートの問いを読み直した。
この違いを、まだ作っていない膜についても使える入力にできるか。
二つの点を当てることだけが、目的ではなかった。
「きっかけの二つが、最初の比較から外れます」
先輩へ話すと、先輩は条件の確認表を見た。
「その二つを含められる方法は、次の検討として残せます。今の規則で比べるなら、ほかの記録と同じ扱いにしましょう」
遥は、膜Aと膜Bの図を捨てなかった。
入力を考えた理由として残す。ただし、新しいモデルで二つの物性差を説明できた例としては使わない。
同じ図にも、置ける場所と、まだ置けない場所があった。
比較用の入力を作るとき、遥は、工程を一行ずつ残した process_steps_v01.csv を直接モデルへ渡さなかった。
record_id で工程をまとめ、順番を確認し、乾燥とその後の処理に対応する条件を、予測用の一行へ取り出す。
drying_temperature_C。
drying_duration_h。
subsequent_treatment_temperature_C。
subsequent_treatment_duration_h。
元の製膜温度の一列は、比較のために別に保持した。新しい入力では、その曖昧な一列をそのまま重ねず、定義した工程ごとの条件に置き換える。
雰囲気の分類は、区分ごとの該当を表す列へ変換することにした。
最初、遥は、文字の種類へ順に 1、2、3 と番号を振っていた。
けれど、k 近傍回帰では、その数字の差も材料間の距離に加わる。番号を付けた順番だけで、二つの雰囲気が近い、遠いという関係を作ってよいだろうか。
遥は、区分ごとに該当するかどうかを 0 と 1 で示す形へ直した。
これは、温度の空欄を 0 ℃で埋める話とは違う。今回照合できた区分を、決めた規則で数字にしている。
減圧の状態と、窒素などの気体の種類も、同じ一列の順序にはしなかった。組み合わせて記載された条件を別々に残せるよう、先輩と分類の意味を確認した。
不明な状態を、確認できた「該当しない」と同じ 0 にはしない。
新しい区分に出会ったとき、黙って全部の列を 0 にせず、対応を確認する必要があることも、入力の説明に書いた。
温度と時間などの連続した数値は、各学習側の平均値と標準偏差で標準化する。区分を表す 0 と 1 の列は、今回はそのまま使う。
どの項目をどう距離へ反映するかも、入力の定義の一部だった。
その変換が動いたあと、遥は、確認用に小さな工程の表を作った。
同じ記録の行を並べ替えても、step_order に従って取り出した入力が変わらないことを確かめる。
次に、途中の処理を一つ増やした。
プログラムは、今回の二段階の形に対応しないと表示し、入力を作る前に止まった。
余分な工程を黙って捨てたり、同じ種類だからと平均したりはしなかった。
「44 行になった」だけでは、まだ安心できない。
どの工程から、どの列の数字が取り出されたかを、数件ずつ元の表と照合した。reported_result_id の重複がなく、各行の目的変数が元の記録と一致することも確認する。
先輩に見せるころには、比較の計画も一枚にまとまっていた。
比較するのは、二つの入力だった。
元の入力:構造記述子と、引き継いだ作製条件の一列。
工程別の入力:同じ構造記述子と、今回定義した工程ごとの温度・時間・雰囲気。
「元の列には、意味の違う温度が混ざっていると分かりました。それでも、もう一度使いますか」
遥が聞くと、先輩は、比較用と書かれた見出しを指した。
「その表し方から何が変わったかを点検するために使います。実際の設計に適切な入力だと、改めて認めるわけではありません」
過去の方法を比べる相手にすることと、採用し直すことは違う。
遥は、両方へ同じ 44 行を渡すことを確認した。
一方だけで欠損値のある行を除いたり、一方だけに追加のデータを使ったりしない。対象行の一覧を共通にし、record_id を見て目的変数の順番もそろえる。
「前の 72 行に対する予測を、この 44 行だけ取り出して使えばよいですか」
先輩に尋ねられ、遥は少し考えた。
「それだと、学習には残りの 28 行も使った場合があります。今回は学習に使える記録もそろえたいので、元の入力でも、44 行から作り直します」
同じ点を評価していても、その点を予測するときに使った情報まで同じとは限らない。
比べる相手をそろえるには、図に残す点だけでは足りなかった。
外側も内側も、structure_group_checked を使った 5 分割にする。
二つの入力方法で、外側に残す記録と、その内側で検証する記録の対応を共有する。新しい表を作った後も、同じ報告結果や同じ構造が両側へ分かれていないかを点検する。
k 近傍回帰を使い、近傍数の候補もそろえた。
candidate_k = [1, 3, 5, 7, 10, 15]
44 行へ減ったので、各学習側に、候補の近傍数を扱えるだけの記録があるかも確認した。
ただし、内側で選ばれる近傍数まで、二つの方法で同じにするわけではない。
入力が変われば、近いと判定される膜も変わる。その入力でどの近傍数を使うかは、同じ内側の評価規則で、それぞれ決める。
「違うのは入力だけ」と言うときにも、学習されたモデルと予測値まで固定されるわけではなかった。
標準化や、学習側で値が一定となる列の処理も、各foldのモデル構築側だけで決める。
最後に、外側で得た推定値を 44 行分集め、同じ対数尺度の MAE と RMSE を計算する。
それぞれの点が、どちらの方法でどの程度変わったかも保存する。
遥は、実行前に、計画の上へ一行を加えた。
入力の案を検討するための、探索中の比較。
この入力を思いついたきっかけは、前の予測誤差だった。外側の分割を使って計算することと、人がまだ一度も結果を見ていないことは同じではない。
今のデータから学び直すことはできる。
でも、その過程を通らなかった最終評価のようには示さない。
週の半ば、二つの計算が終わった。
遥は、結果を表示する前に、対象行と分割の点検結果を開いた。
両方法の対象記録:一致。
外側・内側の構造グループの重なり:0。
解析用の報告結果の重複:0。
その下に、二行の数値が現れた。
元の入力:MAE 0.29、RMSE 0.39。
工程別の入力:MAE 0.26、RMSE 0.38。
二酸化炭素透過係数を常用対数に変換した尺度の誤差だった。
遥は、小さく息を吐いた。
下がった。
構造を確かめて分け直したときは、誤差が大きくなった。工程を読み直し、入力を作り直した今度は、小さくなった。
大きな違いではない。
それでも、画面の 0.26 を見るとうれしかった。
ノートの余白に、前の 0.34 も見えた。
0.34 から 0.26 へ。
そう書けば、改善の幅は大きく見える。けれど、それは違う比較だった。
0.34 は、前の 72 行に対する結果。
0.26 は、今回の 44 行に対する結果。
遥は、発表資料へ貼る表の一番左に、対象記録の数を入れた。
前の結果は、72 行に対する参照として別に置く。今回の入力方法の比較には、同じ 44 行から計算した 0.29 と 0.26 を並べる。
誰かに指摘される前に、その位置を決められた。
一方で、RMSE は 0.39 から 0.38 だった。
MAE の変化ほどには、小さくなっていない。
大きく外れる点は、まだ残っているのかもしれない。
遥は、全体の数字だけで終わらず、二つの予測結果を record_id で結び付けた。
丸める前の絶対誤差を比べると、小さくなったのは 27 行、大きくなったのは 15 行、同じだったのは 2 行だった。
工程を入れたら、すべての点がよくなったわけではない。
そのうち一つは、作製条件の近い記録が近傍に入るようになっていた。別の点では、工程条件を加えたことで構造の近い記録が近傍から外れ、誤差が大きくなっていた。
「作り方が近い」を距離に加えると、「構造が近い」との釣り合いも変わる。
情報が増えることは、都合のよい手がかりだけが自動的に選ばれることではなかった。
遥は、よくなった点と悪くなった点を一つずつ、同じ大きさでスライドに載せた。
差がほとんどない点も、一覧から外さなかった。
「工程を入れると、必ず違う値を予測するんだね」
画面を見た同期に言われ、遥は首を横に振った。
「違う入力にはできる。でも、選ばれる近傍の組が同じなら、今の方法では同じ平均を返すこともある。区別する情報を渡したことと、別々の値を当てられたことは違うと思う」
膜Aと膜Bの図も、もう一度見直した。
この二つの予測を改善した結果は、今回の表にはない。
そう説明しても、工程を整理した意味まで失われるわけではなかった。
木曜日の報告会で、遥は、二枚の散布図より先に、72 行から 44 行へ至る整理を示した。
「最初の比較では、今回定義した二段階の形に対応し、必要な条件を照合できた 44 個の報告結果、20 個の構造グループを対象にしました」
先生は、外した記録の理由を見た。
「44 行になったことで、何に注意しますか」
「対象の構造や工程の範囲が変わりました。残りの 28 行にも同じ改善があるとは言えません。膜Aと膜Bも、必要な項目がそろわず、今回は予測比較に含めていません」
続いて、元の入力と工程別の入力を並べる。
同じ 44 行。同じ内側・外側の分割。同じ回帰手法と近傍数の候補。それぞれの学習側だけで行う前処理。
「外側の推定値を集めた MAE は、0.29 と 0.26 でした。RMSE は、0.39 と 0.38 です。前の 72 行の MAE 0.34 から改善した、とは比較していません」
「では、工程を入れる方法の方がよいですか」
遥は、後ろに用意した各記録の誤差を示した。
「今回の入力定義、データ、分割では、全体の MAE が小さくなりました。ただ、誤差が大きくなった記録もあります。差の安定性や、新しいデータでも同じ傾向があるかは、まだ確認が必要です」
小さい数字が出たことを、隠す必要はない。
しかし、その数字を、確認していない範囲へ広げる必要もなかった。
先生は、工程別の入力の欄を指した。
「乾燥時間を変えれば、性能を改善できると分かりましたか」
「いいえ。今回は、温度、時間、雰囲気をまとめて表し直した比較です。どの項目が予測に役立ったかを一つずつ分けた検討ではありませんし、他の条件をそろえて乾燥時間だけを変えた実験でもありません」
先輩が、よくなった点の近傍一覧を開いた。
「近傍が変わった理由も、見てあります」
先生は、その一覧を少し眺めた。
「同じような工程を使った記録は、いくつの原著論文にありますか」
遥は、出典の列を見た。
同じ論文の番号が、続いている場所があった。
「まだ、工程ごとの出典数までは数えていません」
「今回、構造は分けていますね。では、一つの論文が複数の構造を報告している場合、その論文の別の構造がトレーニング側に残ることはありますか」
「あります。構造を分けたことだけでは、文献に共通する条件まで分かれません」
前の章で、工程名だけを化学的な名前にしても、原因まで分かるわけではないと考えた。
今回は、その問題が、具体的な番号の並びとして現れていた。
ある工程を使った膜の報告が、少数の研究に偏っていれば、その工程と、同じ研究に共通する別の事情を切り分けにくい。
工程を入力にしたこと自体が、間違いと決まったわけではない。
ただ、見えている改善がどこまで別の研究にも持ち出せるかは、次に確かめたいことだった。
遥は、ノートの右側へ書いた。
構造の違いを分けた。
文献に共通する事情は、まだ残る。
先生は、最初の比較計画へ戻るよう促した。
「今日は、この範囲で結果をまとめましょう。次の結果を見て、よくなった点だけを残したり、都合のよい分割へ変えたりはしないでください」
「はい。まず、工程と原著論文の対応を数えて、どの比較ができるかを考えます」
それから遥は、計画の上に置いた「探索中」という言葉を指した。
「入力の案自体は、前の評価結果を見て考えています。今回も、完全に独立した最終評価とはしていません。定義と手順を固めてから、新しく得る記録でも確かめる必要があります」
「そうですね。その違いを残しながら、進めてください」
報告会を終えると、先輩は、遥の比較表をもう一度見た。
「今週は、誤差が小さくなりましたね」
「うれしいです。でも、説明する条件も増えました」
「うれしいことと、まだ確認が必要なことは、一緒にあってよいと思います」
遥は、0.29 と 0.26 の数字を見た。
疑うことは、よい結果を喜ばないことではない。
何を喜べるのかを、自分でも分かるようにすることなのかもしれなかった。
席へ戻り、ファイルを保存した。
process_steps_v02.csv。
process_feature_dictionary_v02.csv。
process_comparison_records_v01.csv。
process_comparison_splits_v01.csv。
process_comparison_predictions_v01.csv。
元の 72 行のデータと、以前の予測結果は別に残している。44 行の表からも、残さなかった理由と、元の工程の記載へ戻れるようにした。
今回の結論を、slack に短く書く。
同じ定義で工程を照合し、最初の比較に使う 44 個の報告結果、20 個の構造グループを定めました。
元の入力と工程別の入力を、同じ対象と内側・外側の分割で比較しました。
MAE は 0.29 と 0.26、RMSE は 0.39 と 0.38 でした。いずれも二酸化炭素透過係数の常用対数の尺度です。
工程別の入力で全体の MAE は小さくなりましたが、悪化した記録もあり、今回の探索範囲の結果として示します。
次は、工程条件が元の実験を報告した論文ごとに偏っていないかを確認します。
送信する前に、「元の実験を報告した」という部分を読み直した。
比較するのは、数字を集めた先の文献だけではない。第2章でたどった、報告結果が生まれた側の文献である。
同じ結果を載せ直した比較表を、別の研究で再現された根拠にはしない。
一度整理した出典の対応が、今度は、結果をどこまで使えるかを考えるための手がかりになった。
ノートの新しいページに、遥は、行に原著論文、列に工程の区分を置いた小さな表を書き始めた。
その隣に、構造グループも書く。
点の色を変えれば、何かが見えるかもしれない。けれど、色がまとまっただけで原因とは決めない。
次は、どの構造とどの工程が、どの研究で確かめられているのかを見たかった。
入力の列が増えた。
比較できる行は減った。
その範囲で、予測誤差は少し小さくなった。
三つを一緒に書くと、今週したことを、大きくも小さくも言いすぎずに残せる気がした。
遥は、0.26 の横に、最後の一行を書き足した。
この改善は、どの記録を、何と比べた結果なのか。
数字だけなら、すぐに写せる。
その横にある条件まで説明できるようになることが、今の自分の研究だった。
===
続きはこちら