データ化学工学研究室物語
第Ⅱ部 高精度モデルの落とし穴
学部四年生から修士課程へ。実際の研究で調べ、試し、考え、自分の問いを育てていく。
第3章 精度が下がった日
四月も半ばを過ぎると、窓際の自分の席から見える景色にも、少し慣れてきた。
机の上には、原著論文を開いたパソコンと、何度も書き直した確認表がある。その隣に、今日は久しぶりに、予測の結果を保存するフォルダを開いていた。
確認した対応関係を使って、データの分け方を作り直す。
前の報告会のあと、ノートに書いた作業だった。
先輩といくつかの論文を読み直し、表と補足資料の対応を確かめた。すべての記録に答えが付いたわけではない。それでも、どこまで確認でき、どこを保留にしたかは、少しずつ見えるようになっていた。
今度こそ、整理したデータでモデルを動かせる。
遥は、baseline_prediction.ipynb のコピーを開いた。
すぐに実行ボタンを押しかけて、その前に、新しい解析用ファイルの行数を確認した。
72 行。
数字が小さくなったことより、その 72 が何を数えたものなのかを、今日は先に書いておきたかった。
今回の確認対象は、引き継いだ解析条件に合う記録のうち、照合を進めた 96 行だった。所定の測定温度で単一気体を測り、二酸化炭素透過係数と、最初のモデルに必要な入力がそろっている範囲である。
そのうち 12 行は、試料や出典の対応がまだ確認できず、暫定的に保留した。
残る 84 行について、同じ報告結果の再掲をまとめると、解析に使う代表の記録は 72 行になった。
確認した構造のグループは、30 個だった。
96 行の収集記録。
12 行は確認を保留。
84 行から、同じ報告結果を一度だけ数えた 72 行。
72 行に含まれる、30 個の構造グループ。
ノートに並べると、どの数字も「データ数」とだけ呼べば、意味が分からなくなりそうだった。
72 行すべてが、互いに何の関係もない実験を表しているわけではない。同じ構造について、別に作製した膜の結果も残している。報告値が何回の測定からまとめられたか、不明なものもある。
遥は、表の上に「確認できた範囲の暫定版」と書いた。
先輩たちが集めた文献データ全体を、確認し終えたという意味ではなかった。
また、保留した記録には、作製方法の説明が短い論文も含まれていた。説明の詳しい資料だけが残れば、扱う構造や条件の範囲も変わるかもしれない。
元の表と解析用の表について、構造の内訳、入力に使う作製条件、透過係数の分布を見比べた。すべてが同じ比率で残っているわけではなかった。
その違いも、今回の結果に付く条件として残すことにした。
「もう計算を始めますか」
紺色のパーカーの先輩が、机の横に来た。
「その前に、作ったファイルが規則どおりかを見ています」
遥は、元の記録と確認表を対応付ける処理を見せた。
行を並べ替えても対応がずれないよう、record_id を使って結び付ける。同じ報告結果をまとめたあとも、代表の記録から、元の出典と他の収集記録へ戻れるようにしていた。
「同じ reported_result_id が、解析用の表に二回出てこないことを確認しました。構造グループが空欄のまま残っている行もありません」
「では、説明変数の方はどうですか」
新しく作った列も、表には並んでいる。
けれど、その番号を物性予測の入力にするわけではない。遥は、モデルへ渡す列名を、実際に出力して見せた。
構造から計算した記述子と、最初の解析で使っていた作製条件。
record_id、source_id、reported_result_id、structure_group_checked は、その一覧にはなかった。
同じ表にあるからといって、全部がモデルの入力ではない。
何を対応付け、何を分け、何から予測するか。それぞれに使う列を、分けていた。
先輩が席へ戻ると、遥はデータ分割の処理を実行した。
学習より先に、各分割に入る記録の一覧だけを保存する。
同じ報告結果が両側にないか。
同じと確認した構造が両側にないか。
その二つを数える、小さな確認処理も付けた。
画面に、注意を示す文字が現れた。
構造グループの重なりあり。
遥は、思わず新しい確認表を開き直した。
同じ構造には、同じ structure_group_checked を付けたはずだった。前の週、二つの構造式と原著論文を並べて確認した箇所も、確かに同じ番号になっている。
それなのに、なぜ分かれるのだろう。
コードの上から、分割に使う変数をたどった。
そこには、前の Notebook から残った指定があった。
structure_group。
確認済みの列を作っても、プログラムは古い番号を読んでいた。
「列を追加しただけでは、使ってくれない」
前の報告会で、自分でも言ったことだった。
分かっていたつもりのことが、そのまま目の前で起きていた。
ただ、今回は予測結果が出る前に止まった。
点検する処理を書いておかなければ、新しいファイルを使ったという理由だけで、安心していたかもしれない。
遥は指定を直し、もう一度、分割だけを作った。
今度は、外側のすべての分割で、確認済みの構造グループの重なりが 0 になった。
ほっとしてから、もう一つ気になった。
近傍数を選ぶため、トレーニングデータの中でも、さらにデータを分けている。
その内側は、何を使って分けているのだろう。
遥は同じ点検を、内側の分割にも付けた。外側のトレーニングデータに残った記録と、それに対応する structure_group_checked だけで、内側のグループ分割を作る。
外側で新しい構造を予測すると決めたなら、近傍数を選ぶときにも、その使い方に合わせて確かめたい。
標準化や、値が一定の特徴量を扱う処理も、それぞれのモデル構築側のデータだけで行われているかを確認した。
処理の名前を見ただけでは、もう終わりにしなかった。
実際にどの記録が入り、どの記録が入っていないかを、出力からたどった。
一通り終えると、遥は、小さな確認用の表を別に作った。
同じ構造の記録を、わざと両側へ一つずつ置く。
点検すると、重なりがあると表示された。
同じ報告結果の再掲を二行残した表では、報告結果の重複を知らせた。
逆に、別に作製した膜の記録を残し、同じ構造として同じ側へまとめれば、今回の点検を通る。
実際の研究データを都合よく動かしたのではない。自分が書いた点検が、何を見つけ、何を許すのかを、答えの分かる小さな表で試していた。
「確認するプログラムも、確認するんですね」
昼休みに先輩へ話すと、先輩は画面を見た。
「0 と出るだけでは、本当に調べられているか分かりませんからね。何を入れたら止まるかまで試したのは、よいと思います」
遥は、短いテスト用の表も保存した。
新しい回帰手法を動かすより、地味な作業だった。
でも、次に自分が列名を間違えたとき、今日の小さな表が助けてくれるかもしれない。
午後、遥は計算の条件をノートへまとめた。
対象は、確認できた範囲の 72 個の報告結果。
目的変数は、二酸化炭素透過係数の常用対数。
説明変数と回帰手法は、最初の解析から変えない。
新しい構造への予測を、確認済みの構造グループを使って評価する。
外側は 5 分割とし、そのトレーニングデータの中で、さらに 5 分割のクロスバリデーションを行う。
近傍数の候補は、今回は次の六つにそろえた。
candidate_k = [1, 3, 5, 7, 10, 15]
内側の推定値を集めた MAE で近傍数を選び、外側のトレーニングデータで学習し直して、残した部分を予測する。
どの分割でも、候補の近傍数を扱えるだけのトレーニングサンプルがあることも確認した。
分割を入れ替え、72 行すべてについて、自分の構造グループを学習に使わなかったモデルの推定値を、一つずつ保存する。
分割ごとの MAE をただ並べるだけでなく、その 72 行の予測誤差から全体の MAE と RMSE を求めることにした。
各foldの行数が完全に同じとは限らないため、どのようにまとめた数字かも、記録に必要だった。
遥は、点検用にもう一つの計算も用意した。
同じ 72 行に対して、引き継いだ古い構造グループ番号を使ったら、評価はどう見えるのか。
これは、新しい方法として採用するための比較ではない。確認済みの構造が両側に入る分割を含むと、数字の見え方がどれくらい違うかを調べるためだった。
本来の解析では、その分割は点検で止める。旧番号の計算は、重なった構造の一覧を付けた点検用として、別に保存する。
同じ報告結果の再掲は、どちらの計算にも入れない。
対象の 72 行、説明変数、目的変数、回帰手法、近傍数の候補、誤差のまとめ方をそろえた上で、内側と外側に使う構造の分け方を変える。
どちらの誤差が小さいかを見て、採用する分け方を決めるわけではなかった。
遥は、実行前のノートを先輩に見せた。
「最初の MAE 0.10 とは、対象データが違います。だから今回は、整理した同じ 72 行でも、古い番号で分ける場合と、確認した構造で分ける場合を比べたいです」
「何が分かる比較でしょう」
「この暫定版で、分け方によって評価がどう変わるかです。古いデータ全体の誤差が小さかった理由を、全部説明する比較ではありません」
「それでよいと思います。どの分割に何が重なったかも、一緒に見ましょう」
遥は、二つの計算を実行した。
画面の下で、処理が順に進んでいく。
エラーは出なかった。
外側の予測結果がそろい、最後に二行の数字が現れた。
旧番号による点検用の評価:MAE 0.16、RMSE 0.23。
確認済み構造による評価:MAE 0.34、RMSE 0.46。
遥は、しばらく画面を見つめた。
こうなるかもしれないとは思っていた。
それでも、0.34 という数字が出ると、胸の奥が重くなった。
先輩の計算を再現したときは、MAE 0.10 だった。文献を調べ、重複を確かめ、プログラムも直した。そのあとで出てきた数字は、前より大きかった。
今週は、何を進めたと報告すればよいのだろう。
隣の同期が、席に戻ってきた。
「計算、終わった?」
「終わった。誤差は、大きくなった」
同期は画面を見てから、机の上に重なった論文を見た。
「ずっと調べてたやつ?」
「うん」
「それは、ちょっとつらいね」
遥は小さく笑った。
正しいことをしていれば、うれしい結果が出る。
そんな約束はないと分かっていても、どこかで期待していたのかもしれない。
ひとまず席を離れ、水を飲みに行った。
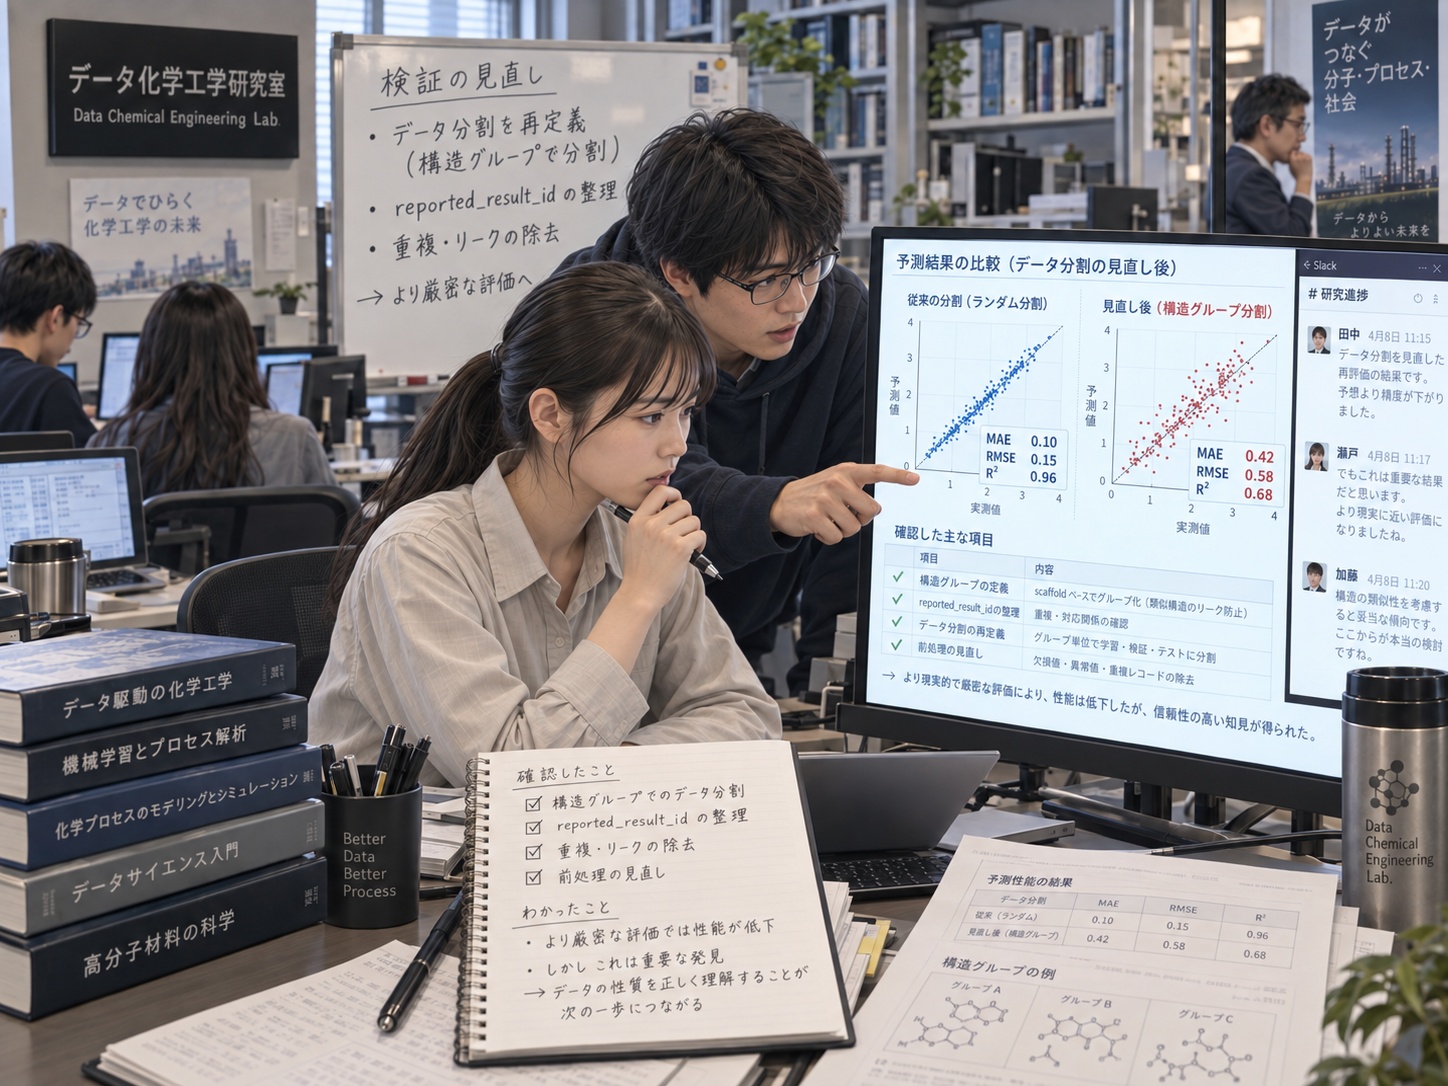
戻ってから、二枚の散布図を同じ軸の範囲で開いた。横軸は報告された透過係数の対数値、縦軸は推定値。対角線は、どちらにも同じ黒い実線で引いた。
旧番号の図で対角線の近くにいたいくつかの点が、新しい図では縦方向へ動き、線から離れていた。
ただし、全部の点が同じだけ外れたわけではなかった。ほとんど変わらない点も、新しい分け方の方が報告値に近い点もある。
遥は、二つの結果を record_id で対応付けた。
どの点が動いたか。
その点を予測するとき、誰がトレーニング側にいたか。
一つずつ、近傍に選ばれた記録を開く。
ある膜の記録では、旧番号の分割に、同じ構造をもつ別の膜の結果が残っていた。再掲ではないが、その高分子構造についての測定値を、モデルはすでに手がかりにできた。
確認済みの構造で分けた場合には、その記録も同じ側へ移っている。
今度は、別の構造をもつ膜の結果から予測しなければならなかった。
モデルに解かせた問題が、違っていた。
同じ学習手順を用いていても、トレーニングデータが変われば、学習されたモデルも変わる。内側で選ばれた近傍数も、二つの計算ですべて同じではなかった。
「同じモデルなのに、精度だけが下がった」
そう一文で片づけることはできなかった。
遥は、比較した一つの記録について、旧番号と確認済み番号で、近傍の顔ぶれがどう変わったかを並べた。
全体の数値の違いを、この一例だけで説明するつもりはない。
ただ、自分が何を変えたのかを、初めて具体的に見ることができた。
翌日の午後、遥はその図を先輩に見せた。
「新しい構造への予測に近づけたら、誤差が大きくなりました」
先輩は、二枚の図を見比べた。
「この結果から、k近傍回帰は役に立たないと言えますか」
「それだけでは言えません。今回のデータと入力、評価した範囲で、これくらい外れたということだと思います」
「では、整理する前の方がよかった?」
遥は首を横に振った。
「新しい構造を予測できるかを知りたいので、同じ構造がトレーニング側にある結果を、そのまま根拠にはできません」
言葉にすると、するべきことは変わっていなかった。
「でも、発表で、精度が下がりましたと話すのが少し怖いです」
先輩は、最初に保存した分割の一覧を開いた。
「小さい数字をなくした話ではなく、どの予測を評価できるようにしたかを話せばよいと思います。もちろん、この誤差で十分かどうかは、別に考える必要があります」
「厳しく評価したから、これで終わりということでもないんですね」
「そうです。誤差を大きくすることが目的ではありません。今できることを確かめて、その先に必要な検討を考えるためです」
遥は、スライドの題名を消した。
予測精度の低下。
その代わりに、こう書いた。
確認した構造を分けた評価と、残った予測誤差。
数字は、一つも変えなかった。
木曜日の報告会では、最初に、今回のデータの範囲を示した。
確認した 96 行から、保留した記録と同じ報告結果の再掲を区別し、72 行を解析に使ったこと。その中に、30 個の構造グループがあること。
先生は、72 という数字を指した。
「元のデータを、全部調べ終えたのですか」
「いいえ。今回までに照合した範囲の暫定版です。保留した理由と、まだ照合していない範囲も残しています」
続いて、遥は分割の点検結果を示した。
「確認済みの構造グループと reported_result_id は、外側だけでなく、内側でも両側に重なっていないことを確認しました。古い番号では、異なる番号の同じ構造が、両側に入る分割がありました」
「点検に使ったコードは、確かめましたか」
「小さな表で、同じ構造や同じ報告結果をわざと重ねたとき、見つけられるか試しました。点検用の表も保存しています」
先生はうなずいた。
遥は、二枚の散布図へ進んだ。
「同じ 72 行を一度ずつ外側で予測した結果です。MAE は、旧番号による点検用の評価で 0.16、確認した構造で分けた評価で 0.34 でした。RMSE は、それぞれ 0.23 と 0.46 です」
「最初の 0.10 から、なぜ 0.34 になったかも、これで分かりましたか」
「全部は分かりません。最初の結果とは対象サンプルも、重複の扱いも、分割も違います。今回の比較で確かめたのは、整理した同じ 72 行に対し、構造の分け方を変えた場合の違いです」
「それなら、0.16 と 0.34 の比較では、何に注意しますか」
「評価した報告結果と誤差の尺度は同じです。ただ、分割によって学習に使えるデータが変わります。よりよい回帰手法を選んだ比較ではなく、何を未知として予測したかが異なる比較です」
同じ数字の列を並べても、何を比較したことになるかは、条件によって違う。
遥は、外側の予測結果には各行の誤差を残していることも説明した。r2 を計算した場合も、異なるサンプル集合の値を直接比べる指標にはしない。今回の説明は、同じ対数尺度の MAE と RMSE を中心にした。
先生は、新しい分割の図を見た。
「この 0.34 が、これから出会うあらゆる高分子膜の誤差ですか」
「違います。今回の暫定データに含まれる構造を、グループごとに学習から外した評価です。このデータにない、さらに離れた構造にまで、そのまま当てはまるとは言えません」
「同じ構造が入らなければ、研究室や測定方法の違いも、全部独立になりますか」
「なりません。同じ原著論文が複数の構造を報告していれば、文献や測定方法の共通性は両側に残ることがあります。今回そろえたのは、まず新しい構造を予測するための分け方です」
先生は、それ以上の分割方法を、その場ですべて試すようには言わなかった。
「どの違いを確かめた結果かが分かれば、次に残る問題も分かります。今の段階では、その範囲を明確にして進めましょう」
遥は、ずっと気になっていたことを尋ねた。
「この誤差でも、研究を進めてよいのでしょうか」
先生は、少し考えた。
「もちろんです。ただし、今の予測だけで実験候補を決めてよいかとは、別の話です。何を判断するために、どの程度の誤差なら使えるかを、これから具体的にしていきましょう」
「0.34 なら合格、という決まりはないんですね」
「はい。厳しく分けたという理由で、どんな誤差でもよいことにはなりませんし、大きな誤差が出たという理由だけで、研究をやめる必要もありません」
遥は、次に何をすればよいかを、先生に聞こうとした。
その前に、昨日作ったもう一枚の図を開いた。
課題として言われたわけではない。
誤差の大きい記録を見ている途中で、気になった二つの点だった。
「この二つを、もう少し調べたいです」
同じ構造グループに属し、別に作製された膜の報告結果だった。再掲ではないことは、前の確認で調べている。
モデルへ渡した列をすべて並べると、構造記述子と、入力に使った作製条件の数値が一致していた。
しかし、報告された透過係数は違う。
同じ外側の分割で、二つとも学習から外されていた。その同じモデルに同じ入力を渡したため、推定値は同じになっている。
散布図では、二つの点が同じ高さに並んでいた。
「同じ入力なら、今のモデルでは、この二つに別々の値を返せません。回帰手法を変える前に、入力で何を区別できていないかを確認したいです」
「測定誤差でしょうか」
「その可能性もあります。でも、作り方の違いを入力に残せていない可能性もあります。今は、そのどちらかに決められません」
先生は、二つの点の横にある記録番号を見た。
「何から確かめますか」
「まず、同じ数値になっている作製条件の列が、二つの論文で同じ工程を指しているかを調べます。実験方法に書かれた手順を、時間の順に並べてみたいです」
一つの欄に温度が入っていても、溶媒を取り除くときの温度なのか、膜を作った後の処理の温度なのかは、列名だけでは分からない。
すでに調べた構造と報告結果の来歴に加えて、今度は作り方の意味をそろえる必要があるのかもしれなかった。
先生は、短く答えた。
「それなら、この二つから始めましょう」
報告会が終わると、遥は新しい結果を保存した。
membrane_modeling_v03.csv。
checked_group_splits_v03.csv。
split_audit_v03.csv。
checked_group_predictions_v03.csv。
どの記録を使い、どこで分け、どの前処理と近傍数で予測したかを、結果に結び付けて残す。
旧番号を使った点検用の結果は、本来の予測性能と取り違えない名前で、別に保存した。
今回は、しきい値を変えて都合の悪い点を除いたり、誤差の大きい構造だけを評価から外したりはしなかった。AD内に限った評価を追加する場合も、全体の結果とは分けて示す必要がある。
画面の 0.34 は、まだ大きく感じられた。
それでも、数字を出した経路と、その数字が表す範囲は、前より自分でたどれるようになっていた。
遥は、slack に今回の報告資料を共有した。
確認済みの構造で内側・外側の分割を作り、重なりを点検した上で評価しました。
今回の暫定版では、72 個の報告結果、30 個の構造グループを対象に、外側の推定値を集めた MAE が 0.34、RMSE が 0.46 でした。いずれも二酸化炭素透過係数の常用対数の尺度です。
引き継ぎ時の MAE 0.10 とは対象が異なり、数値だけで手法の良し悪しは比較していません。
次は、同じ入力なのに報告値が異なる二つの膜について、作製手順と、入力にした条件の定義を確認します。
送信したあと、先生から質問されるかもしれないと思い、確認表の場所も追記した。
待っている間に、二つの原著論文を開く。
比較するのは、今日は物性の表ではなかった。
実験方法の節に、手順を表す言葉が続いている。
溶かす。膜にする。乾かす。処理する。測る。
一つの温度の数字だけでは、その前後は見えない。
遥はノートへ二本の線を引き、それぞれの膜を作った手順を書き込む場所を作った。
高い予測精度が出れば、研究は前へ進む。
四月の最初には、そう思っていた。
今日は、誤差が大きくなった。
でも、次に確かめたいことは、前よりはっきりしている。
数字を小さくする方法を探すだけでなく、なぜ同じ入力から違う結果が生まれるのかを知りたい。
遥は、二本の線の上に、同じ問いを書いた。
この膜は、どのように作られたのか。
===
続きはこちら