回帰分析やクラス分類を行うとき、どのようなモデルを使用するかだけでなく、どのような特徴量をモデルに入力するかも重要です。分子・材料の物性や活性を予測する場合も、製造プロセスの品質を予測する場合も、目的変数に関連する情報を、モデルが扱いやすい形で表現したいところです。
特徴量設計については、以前の「手動・自動の特徴量エンジニアリングの考え方」でも紹介しました。今回は、オートエンコーダのエンコーダを、特徴量を作成するために活用することについてお話しします。
オートエンコーダは、低次元化だけのためのものではない
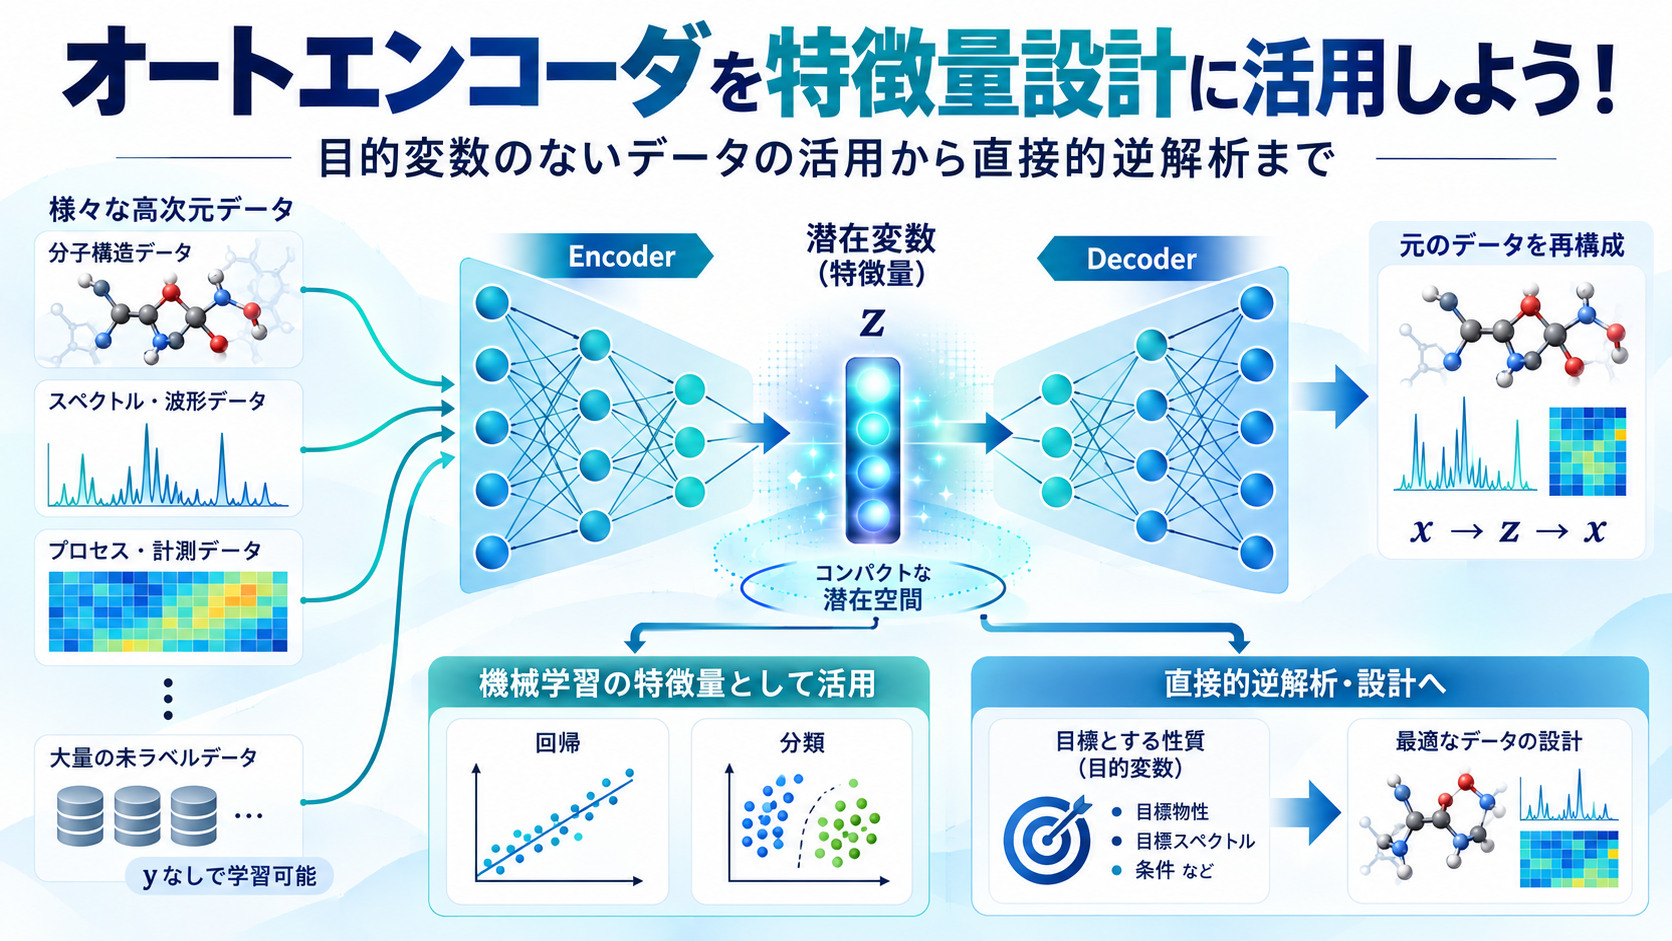
オートエンコーダは、入力データを潜在変数に変換するエンコーダと、潜在変数から元の入力データを再構成するデコーダから構成されます。元の入力を x、潜在変数を z とすると、基本的には「x → z → x」という変換を行い、入力した x と再構成した x が近くなるように学習します。学習後は、エンコーダを取り出すことで、新たなサンプルについても x から z を計算できます。
ただ、オートエンコーダといっても、一種類ではありません。多層のニューラルネットワークを用いるディープオートエンコーダ、ノイズを加えた入力から元の入力を復元するデノイジングオートエンコーダ、潜在表現の一部だけが活性化するように制約を加えるスパースオートエンコーダなどがあります。また、変分オートエンコーダ(Variational Autoencoder, VAE)のように、潜在変数を確率分布として扱う方法もあります。画像やスペクトルには畳み込み構造を利用するなど、学習方法だけでなく、ネットワークの構成にもさまざまな選択肢があります。
オートエンコーダというと、高次元のデータを少数の潜在変数に圧縮する、すなわち低次元化するもの、というイメージがあるかもしれません。しかし、用途はそれだけではありません。分子構造のように、そのままでは一般的な回帰モデルに入力できる固定長の特徴量になっていない情報を、数値ベクトルに変換することにも利用できます。もちろん、ネットワークへの入力時には、構造を文字列やグラフなどとして表現し、それに対応した数値的な符号化を行う必要があります。そのうえで、構造の情報を学習し、回帰分析などで使用できる潜在変数に変換するわけです。
そして、このエンコーダの出力である潜在変数 z を、そのまま特徴量として使用できます。 目的変数を y とすると、元の x と y の間ではなく、z と y の間で回帰モデルやクラス分類モデルを構築することになります。低次元化はそのための一つの手段であり、潜在変数の数を小さくすること自体が最終目的というわけではありません。
オートエンコーダの学習には、目的変数がなくてもよい
ここで重要なのは、通常のオートエンコーダの学習に用いるサンプルには、目的変数 y の値がなくてもよいということです。入力から入力自身を再構成するように学習するため、物性値やクラスのラベルをすべてのサンプルに用意する必要はありません。
例えば、学習に利用できる分子構造が10万件あり、そのうち物性値が測定されているものは500件だけ、という状況を考えます。この場合、物性値のある500件だけでオートエンコーダを学習する必要はありません。10万件の構造を用いてエンコーダとデコーダを学習し、その後、物性値のある500件について潜在変数を計算して、潜在変数と物性値の間で回帰モデルを構築する、という使い方ができます。
このように、特徴量を学習するためのデータと、目的変数を予測するモデルを学習するためのデータを分けて考えることがポイントです。「目的変数の測定値がないので、このサンプルは学習に使えない」と考えるのではなく、「特徴量を作るためには使えるのではないか」と考えてみましょう。
ただし、データが大量にあれば何でもよいわけではありません。学習する構造やデータの種類が、実際に予測したい対象とかけ離れていれば、必要な情報を表現できない可能性があります。目的変数のないデータを増やしたことで、本当に予測性能が向上したかは検証する必要があります。
ハイパーパラメータは、特徴量を使用する目的に合わせて決める
オートエンコーダを使うときには、種類、層の数、各層のノード数、潜在変数の数、正則化の強さなど、多くのハイパーパラメータを決めることになります。
ここで、「元のデータを最も精度よく再構成できる設定を選べばよい」と考えたくなりますが、特徴量として使用する場合には、それだけでは不十分です。x をよく再構成できることと、y をよく予測できることは、同じではありません。 x の再構成には重要でも y の予測にはあまり関係しない情報もありますし、x 全体から見ると小さな違いであっても、y には大きく影響する情報も考えられます。
そのため、回帰分析に用いるのであれば回帰モデルの予測性能、クラス分類に用いるのであれば分類性能を基準として、オートエンコーダの種類や構成を含めて最適化することが重要です。後段の回帰・クラス分類モデルのハイパーパラメータも合わせて検討するとよいでしょう。潜在変数を用いたモデルと、元の特徴量をそのまま用いたモデルなどを、同じデータ分割で比較することも大切です。
「先ほど、オートエンコーダには y が不要と言ったのに、y を使って最適化するのですか?」と思うかもしれません。ここは分けて考える必要があります。エンコーダとデコーダの重みを、入力の再構成を目的として学習する段階では y は不要です。一方、学習した複数の候補の中から、目的に合った特徴量を与えるものを選ぶ段階では、y のあるデータで性能を比較します。すべてのサンプルに y が必要になるわけではありません。
なお、未知のサンプルに対する予測性能を評価する場合、最終テストデータはオートエンコーダの学習やハイパーパラメータの選択からも分離しておきます。標準化や特徴量の学習を含めて、どのデータをどの段階で使用したかを明確にし、テストデータの情報が学習に入り込まないように注意しましょう。
エンコーダだけを使う場合も、サンプル間の類似性が重要
さらに注意したいのが、元のデータ空間と潜在変数空間における、サンプル間の類似性です。
説明変数の値や構造が似ているサンプルは、潜在変数空間でも似ていてほしいところです。一方、それだけでなく、潜在変数空間で似ているサンプルは、元の説明変数や構造も似ているという逆向きの関係も重要です。つまり、近かったサンプルを不必要に引き離さないことと、異なるサンプルを不適切に近づけないことの両方を考える必要があります。通常の再構成誤差の最小化だけでは、このような距離や近傍関係の保存は保証されません。
例えば、エンコーダで潜在変数の一つの方向だけを大きく引き伸ばし、デコーダでその分を縮めることを考えてみます。元のデータを復元することはできても、潜在変数空間におけるサンプル間の距離や、どのサンプルが近いかという関係は変わり得ます。したがって、再構成がうまくできているからといって、その潜在変数が特徴量として使いやすいとは限らないのです。
この問題に対応するには、元のデータ空間と潜在変数空間の距離や近傍関係が大きく食い違わないように、学習時の損失関数に項を追加することなどが考えられます。エンコーダやデコーダの変化の仕方に制約を与え、局所的な構造を保つ方法もあります。予測時にはエンコーダだけを使う場合であっても、学習時には、このような潜在空間の性質を考慮することが大事です。
ただし、何をもって「似ている」とするかは、対象と目的によって決める必要があります。構造のどの部分を重視するのか、スペクトルの形状と強度のどちらを重視するのか、といった点も含めて検討します。すべての距離を完全に一致させることを目指すというより、予測や設計に必要な類似関係を保つことを目指したいところです。この制約の強さも、特徴量を使用する目的に合わせて調整しましょう。
デコーダを利用すると、直接的逆解析にもつながる
ここまでは、エンコーダの出力を特徴量として使用する話でした。しかし、せっかくデコーダも学習しているのであれば、モデルの逆解析にも活用できます。
潜在変数 z から目的変数 y を予測する「x → z → y」という順解析に対して、目標の y を与えて z を求め、その z をデコーダに入力すれば、「y → z → x」という逆解析ができます。もちろん、デコーダだけで目標の y から x が得られるわけではなく、まず y から z を求める仕組みが必要です。この考え方は、「低次元化を駆使して直接的逆解析法の予測精度を向上させる手法を開発しました!」でも紹介しています。
ここで、潜在変数空間に仮想サンプルを大量に生成し、それぞれについて y を予測して、目標に近いものを選ぶことも考えられます。ただ、低次元化した後であっても、潜在変数の数が多ければ、網羅的に候補を生成することは難しくなります。例えば、20個の潜在変数について、それぞれ10通りの値を考えるだけでも、組合せは 1020 通りになります。
このような場合に有効なのが、直接的逆解析です。例えば、混合ガウス回帰(Gaussian Mixture Regression, GMR)を用いて z と y の同時分布をモデル化すると、目標の y を条件とした z の分布を求め、その分布から候補を得られます。潜在変数空間の全組合せを先に生成する必要がなく、得られた z をデコーダで元の x や構造に変換できます。
金子研では、超高次元データをオートエンコーダで低次元化し、直接的逆解析につなげた研究も行っています。ただし、直接的逆解析によって得られるものは、あくまで学習したモデルに基づく候補です。デコーダで生成できることと、実際に合成・実施できること、さらに目的の性能を達成することは区別して、実験やシミュレーションなどで検証する必要があります。
オートエンコーダを、単に変数の数を減らすための方法と考えるだけでは、もったいないと思います。目的変数のない大量のデータから特徴量を学習し、その特徴量を回帰分析やクラス分類に使用し、さらにデコーダを通して逆解析にもつなげることができます。
その際には、「元のデータが復元できるか」だけでなく、「目的変数を予測するのに役立つか」「必要な類似関係が保たれているか」「設計した潜在変数を意味のある候補に戻せるか」まで考えて、オートエンコーダを設計・評価しましょう。
以上です。
質問やコメントなどありましたら、X, facebook, メールなどでご連絡いただけるとうれしいです。