データ化学工学研究室物語
第Ⅱ部 高精度モデルの落とし穴
学部四年生から修士課程へ。実際の研究で調べ、試し、考え、自分の問いを育てていく。
第6章 同じ色の近傍
五月の半ば、遥は、前の週と同じ散布図に色を付けていた。
予測し直したわけではない。
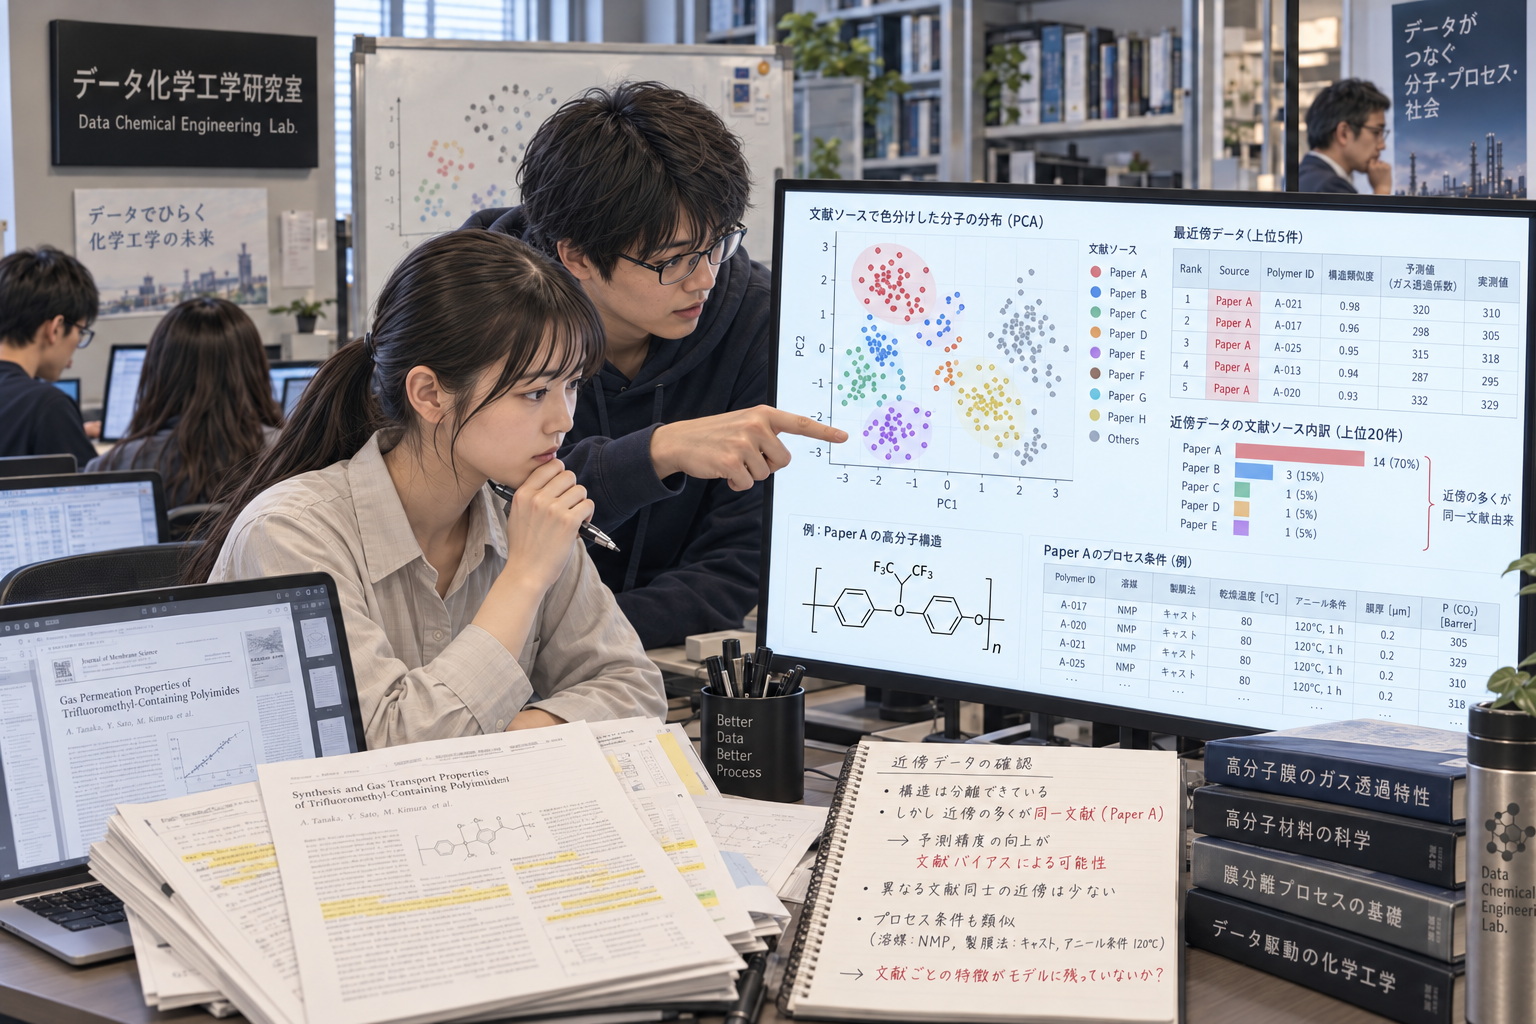
44 個の報告結果も、20 個の構造グループも、点の位置も変えていない。変えたのは、その数字を最初に報告した原著論文ごとに、点を見分けられるようにしたことだった。
画面の横には、前の比較が残っている。
元の入力:MAE 0.29、RMSE 0.39。
工程別の入力:MAE 0.26、RMSE 0.38。
二酸化炭素透過係数を常用対数に変換した尺度で、同じ 44 行を比べた結果だった。
少し小さくなった誤差を、もう少し安心して説明したい。
けれど、先生から聞かれたことには、まだ答えていなかった。
同じような工程を使った記録は、いくつの原著論文にあるのか。
遥は、数字を集めた先の source_id を、そのまま色の指定には使わなかった。第2章で作った照合表から、各 reported_result_id が、どの原著論文の報告結果に対応するかをたどった。
比較表へ載せ直された同じ値は、すでに一つにまとめている。その値を引用した文献が何報あっても、色を増やす理由にはしない。
今回の 44 行がたどり着いた原著論文は、9 報だった。
遥は、それぞれに P01 から P09 までの番号を付け、original_paper_id という列へ保存した。番号から文献名と該当する表へ戻れるようにする。
この番号は、出典をまとめて確認するためのものだった。新しく予測する膜の性質を教えてくれる説明変数ではない。
九つの色だけでは見分けにくかったので、点の形も変えた。画面上の点を選ぶと、record_id と原著論文の番号が表示されるようにした。
同じ色が、まとまっている場所があった。
「論文で分けたの?」
隣の同期が、椅子を少し寄せた。
「うん。工程を詳しくしたら、どの記録が近くに選ばれるようになったかを見てる」
「色がまとまってるなら、論文の違いを覚えてるんじゃない?」
遥も、一瞬そう言いかけた。
でも、同じ論文が、似た高分子をまとめて調べていた可能性もある。同じ作り方を使っていた可能性もある。点の色だけでは、そのどれかを選べない。
「その可能性を調べたい。ただ、まだ色を変えただけだから」
遥は、散布図の隣に、新しい表を開いた。
行には原著論文。列には、乾燥とその後の処理について確認した雰囲気の組み合わせを置く。各欄に、報告結果の数を入れた。
数値の温度や時間は、色をきれいに分けるために区切り直さず、そのままの値の範囲も横に残した。
一つの組み合わせには、8 行があった。
8 個あれば、それなりに確かめられている気がする。
けれど、原著論文の番号を数えると、一つだった。その 8 行には四つの構造が含まれていたが、すべて P01 の中で報告されていた。
8 個の報告結果。
四つの構造。
一つの原著論文。
どれも、同じ欄を説明する数字だった。
遥は、8 の隣に、四つと一つを書き足した。
原著論文の数だけで研究の質が決まるわけではない。それでも、8 行あることを、八つの別の研究で確かめられたことのようには扱えなかった。
次に、原著論文と構造グループの対応を並べた。
一つの論文が複数の構造を調べている。
同じ構造が別の論文にも現れる。
論文と構造は、一対一には対応していない。
前の構造グループ分割で、何が分かれて、何が残ったのかが、ようやく表の形で見えた。
午後、遥は、工程別の入力で誤差が小さくなった一つの点を開いた。
その点を予測した外側の分割では、同じ構造の記録は、すべて学習から外されている。点検結果にも、重なりはない。
一方、近傍に選ばれた別の構造の膜には、同じ P01 の色がいくつもあった。
工程の温度、時間、雰囲気が近い。原著論文の工程説明にも、共通する部分がある。
モデルは、論文名を直接読んではいない。
ただ、工程を表す数値を通して、同じ論文の記録を選びやすくなっていた。
紺色のパーカーの先輩に見せると、先輩は近傍の一覧を指した。
「この近傍が選ばれたことは、間違いでしょうか」
「同じような工程の別の構造を参考にすること自体は、間違いではないと思います」
「では、何が気になりますか」
遥は、P01 の行へ戻った。
「工程が似ていることと、その論文に共通する別の条件が、重なっていることです。この工程を別の研究で使った膜にも、同じように予測できるかが気になります」
膜の作り方のうち、今の入力にない条件もある。試料の扱い方、測定前の保管、装置や測定手順についても、すべてそろえたわけではない。
同じ論文の中では共通していて、別の論文へ移ると変わる事情が、まだ残っているかもしれなかった。
「工程そのものが予測に役立った場合と、工程が別の共通点の目印になった場合を、今の表だけでは切り離せません」
遥が言うと、先輩はうなずいた。
「その区別を確かめたいんですね。ただし、原著論文を分ければ、全部の条件が独立になるわけでもありません。同じ研究グループの別の論文もありますから」
遥は、P01 と P02 を違う色にしたことを思い出した。
別の色を塗ったのは、自分だった。
その色が違えば、原料も装置も研究者も違うと確認したことにはならない。
「今回は、まず元の報告論文が重ならない場合を点検します。別の研究室でも使えると証明した、とは言いません」
先輩は、これまでの構造グループ分割の図を開いた。
「その場合、構造はどうしますか」
「同じ構造も、学習側へ残さないようにしたいです。もとの目的は、新しい構造と作製条件の候補を考えることなので」
二つの番号を使えばよい。
そう考え、遥は structure_group_checked と original_paper_id を、組にして一つの札へまとめかけた。
構造が S01、論文が P01 なら、S01_P01。
違う組には違う札が付く。これで、二つの条件を同時に分けられるだろうか。
プログラムを全データへ適用する前に、遥は三行だけの表を作った。
記録 a:構造 S01、原著論文 P01。
記録 b:構造 S01、原著論文 P02。
記録 c:構造 S02、原著論文 P01。
三つの組の札は、すべて違う。
しかし、記録 a を評価側へ置いたとき、b を学習側に残せば、同じ構造が残る。c を残せば、同じ原著論文が残る。
組が違うことと、構造も論文も重ならないことは違った。
遥は、小さな表に、赤い線を二本引いた。
同じ構造を結ぶ線。
同じ原著論文を結ぶ線。
「二列を一つにしただけでは、解決していませんでした」
先輩は、線のついた三行を見た。
「今の点検で、それが分かりましたね。何を評価側に残し、何を学習から外すのかを、そのまま手順にしてみましょう」
遥は、自分が知りたい場面を、もう一度書いた。
その原著論文の報告を使わず、同じ高分子構造の報告も使わずに、対象の値を予測する。
最初に、一つの原著論文の記録を、まとめて評価側に残す。
次に、残った学習用の候補から、評価側と同じ構造の記録を外す。
外した記録は、その回の学習には使わない。ただし、元のデータから削除したわけではない。自分の原著論文が評価側へ回るときには、評価の対象になる。
これなら、その回に予測する膜と、同じ論文、同じ構造のどちらも学習側へ残らない。
ただ、その分、モデルが参考にできる記録は減る。
遥は、評価側、学習側、同じ構造のため学習に使わない記録を、それぞれ別の欄へ書いた。
「学習側から外す記録を、評価側へ全部移すわけではないんですね」
先輩に確認され、遥はうなずいた。
「はい。評価側は、その回に選んだ原著論文の記録です。構造の重なりを避けるために外した別の論文の記録とは、役割を分けます」
一つの線で左右に分けるだけだと思っていたデータ分割に、もう一つ置き場所ができた。
遥は、三行の表で、その置き場所も確かめた。
記録 a の論文を残したとき、同じ論文の c も評価側へ行く。同じ構造をもつ b は、学習側から外れる。この三行だけなら、モデルを学習するための記録は残らない。
そのときは、計算できないと知らせて止まる。
小さな表だからこそ、何が起きるべきかを、自分で説明できた。
対話型 AI には、自分で決めた手順と、この点検用の表を示した。
構造と原著論文の重なりを避けるための分割です。処理が間違っているときに気づける点検例を、追加で挙げてください。研究データの値や、評価結果は推測しないでください。
回答には、行の順番を入れ替えた場合、同じ構造が三つの文献へまたがる場合、構造番号のない行が混ざった場合などが挙がった。
遥は、期待する結果を先に書き、小さな表で順に試した。
AIの説明が正しそうだからではなく、処理を間違えたら止まるかを、実際の出力で確かめる。
今度は、その作業を始める理由を、先輩に聞かれる前に持っていた。
翌日、遥は比較の計画をまとめた。
対象は、前の週と同じ 44 個の報告結果、20 個の構造グループ。
入力は、元の入力と工程別の入力の二通り。
外側では、9 報の原著論文を一つずつ評価側へ回す。
各回の学習側から、評価側と同じ構造をもつ記録も外す。
二つの入力方法で、その対応を共通にする。
近傍数を選ぶ内側でも、その時点の学習用データの中で、原著論文を一つずつ検証側へ回し、同じ構造をモデル構築側から外すことにした。
外側だけを厳しく分け、内側では別の問いで選ぶ、という形にはしない。
温度や時間の標準化、一定値となる列の扱いは、各回のモデル構築側だけで決める。雰囲気の区分は、前の章で決めた定義と変換を引き継ぐ。
近傍数の候補も、前と同じにした。
candidate_k = [1, 3, 5, 7, 10, 15]
実データの分割を作って数えると、今回の内側・外側のすべてのモデル構築側で、その候補を扱える件数は残っていた。件数だけで十分に似た膜が残るとは限らないので、構造の内訳と条件の範囲も保存した。
各回に同じ報告結果、同じ構造、同じ原著論文が両側へ入っていないことを点検する。
外側の推定値を集めれば、44 行のそれぞれに、自分の原著論文と構造の情報を使わなかった予測が一つずつ付く。
9 報の誤差をただ平均するのではなく、まずは 44 行の誤差から、前と同じ対数尺度の MAE と RMSE を計算する。その隣に、論文ごとの件数と誤差も置く。
多くの記録を報告した論文の結果は、行をまとめた平均に、それだけ多く寄与する。そのことも見えるようにしたかった。
「どちらの入力でも、同じ論文と構造を学習から外しています」
遥は、実行前の計画を先輩に見せた。
「ただ、前の構造だけの分割と比べると、学習に使う記録数も、残る構造や工程も変わります。誤差が変わった分を、全部『文献に共通する事情の影響』とは呼べません」
「そこは大切ですね。どの条件で比べた結果かを、二段に分けて示しましょう」
前の分割の中で、二つの入力を比べる。
今回の分割の中で、同じ二つの入力を比べる。
その違いを見れば、少なくとも、改善がどの条件で見えていたかを調べられる。
今あるデータと結果を見て考えた、探索中の点検であることも、計画の上に残した。
木曜日の朝、計算した結果を開くと、前の表の下に、もう二行が並んだ。
原著論文と構造の重なりを避けた点検。
元の入力:MAE 0.35、RMSE 0.47。
工程別の入力:MAE 0.36、RMSE 0.49。
遥は、最初に 0.26 を見てから、今度の 0.36 を見た。
一週間前のうれしさを、少しだけ返すような気分になった。
工程を整理した努力まで、取り消されたわけではない。そのくらいは、もう分かっている。
それでも、二つの入力の順番が逆になると、何を報告するか迷った。
画面を閉じる代わりに、各原著論文の結果へ移った。
9 報のうち、工程別の入力の方が MAE の小さいものは五つ、大きいものは四つだった。ところが、件数も誤差の変化量も同じではないため、44 行をまとめた MAE は工程別の入力の方が少し大きい。
よくなった論文が過半数なら、全体でもよくなる。
そう単純には決まらなかった。
P01 では、工程を詳しくしたときの改善が、今度の点検では残らなかった。
前の分割で近くにいた同じ色の膜は、今回は全部、学習側からいなくなっている。他の論文にある膜だけから、値を推定していた。
一方、別の原著論文では、工程別の入力の方が誤差は小さかった。
工程が役立たない、とまとめれば、そちらの記録を説明できなくなる。
遥は、二つの例を並べた。P01 だけを選んで結論を作らず、九つすべての結果も残した。
やがて、先輩が席へ来た。
「どうでした?」
「前と同じようには、改善しませんでした。別の原著論文と別の構造から予測する条件では、全体の MAE は 0.35 と 0.36 でした」
「では、元の入力の方が優れていると決めますか」
遥は首を横に振った。
「今回の計算では、元の入力の MAE の方が小さいです。でも、少数の文献での小さな差なので、広い範囲で優れているとは言えません。それに、意味の違う温度を混ぜた一列を、そのまま新しい膜の設計に使ってよい理由にもなりません」
小さい数字を返すことと、これから作る膜について意味のそろった入力を用意できることは、別に考える必要があった。
工程別に表せるようになった。
その表し方が、別の報告にも役立つかは、まだ十分には確かめられていない。
二つを、一つの勝ち負けにしなくてもよかった。
報告会では、遥は、色を付けた図と、原著論文と工程の対応表を最初に映した。
「今回の 44 行は、9 報の原著論文に由来していました。ある工程の組み合わせは 8 行ありましたが、その範囲では一つの論文にまとまっていました」
先生は、8 と書かれた欄を見た。
「同じ色が多ければ、データリークでしょうか」
「それだけでは決められません。前の比較は、確認した構造を外して予測する条件でした。同じ論文の別の構造が学習側に残ることは、その条件では起こります。ただ、その結果を、文献に共通する事情まで切り離した性能とは説明できません」
「今回の点検なら、別の研究室での性能まで分かりますか」
「そこまでは分かりません。別の論文でも、研究者や測定手順が共通することがあります。今回分けたのは、原著論文の番号と確認済みの構造です」
先生は、分割の図へ目を移した。
遥は、評価側と、同じ構造のため学習から外した記録を、色ではなく位置で区別して説明した。
「評価する記録は同じ 44 行です。ただ、前とは学習に使える記録が違います。外側だけでなく内側にも同じ考え方を使い、両方の入力方法で、各回の記録の対応をそろえました」
続いて、二つの条件の結果を並べた。
構造だけを分けた前の比較では、元の入力が MAE 0.29、工程別の入力が 0.26。
原著論文と構造の重なりを避けた今回の点検では、それぞれ 0.35 と 0.36。
どれも、二酸化炭素透過係数の常用対数の尺度だった。RMSE と各論文の件数も、同じ画面へ置いた。
「それなら、前の改善は、論文に共通する条件を覚えたせいですか」
先生に聞かれ、遥は、工程と原著論文の対応表へ戻った。
「その可能性を考える理由は増えました。でも、今回の結果だけで原因とは決められません。同じ論文を外したことで、実際に役立つ構造や工程の手がかりも減っています」
「何が言えますか」
「工程別の入力による全体の MAE の改善は、今回試した別の評価条件では確認できませんでした。どの論文でも一様によくなったわけでもありません。別の研究へ持ち出せる改善だと、今の結果だけで主張するのは難しいです」
前の 0.26 を消していないことも話した。
その数字が得られた条件は、今も説明できる。今回の結果が出たからといって、過去の計算が存在しなかったことになるわけではない。
先生は、対応表の空いた欄を指した。
「では、その違いをもう少し確かめるには、どんな記録が必要でしょう」
遥は、少し前なら「データを増やします」と答えたと思った。
今は、増やしたい場所があった。
「今の表では一つの論文に偏っている工程を、別の報告でも確かめたいです。それから、同じ高分子で工程だけを変えた比較と、その比較を別の高分子でも行った記録があると、工程と構造の違いを整理しやすくなると思います」
「新しい論文を一報加えれば、独立な確認になりますか」
「引用された同じ値の再掲かもしれないので、出典の対応から確かめます。今回の方法を考えるためにすでに読んだ結果かどうかも残します。新しいファイルに保存するだけでは、新しい評価にはなりません」
遥は、探索中と書いた見出しを指した。
「方法の定義と評価の規則を記録してから、まだその判断に使っていない記録で確かめる計画を作りたいです。どの記録を探すかも、結果がよくなりそうだからではなく、確認したい比較から決めます」
先生はうなずいた。
「よいと思います。ただ、文献だけで必要な比較がそろうとは限りません。作る人とも、どこまで条件をそろえられるか相談しましょう」
報告会のあと、遥は、前に工程の図を見てもらった大学院生へ相談するため、資料を一枚にまとめた。
画面いっぱいの入力表ではなく、何を確かめたいかが分かる図にした。
同じ高分子について、二つの作製条件を比べる。
その対比を、別の高分子でも確かめる。
四つの箱を描くと、実験計画らしく見えた。
けれど、まだ温度や時間を自由に入れてよい箱ではない。どの範囲なら膜を作れ、他の条件をどこまでそろえられるかは、これから相談する内容だった。
先生を交えた短い打ち合わせで、その図を見せた。
大学院生は、二つの条件を結ぶ矢印を見た。
「どの操作だけを変えたいですか。それとも、文献にある二つの手順全体を比較したいですか」
遥は、矢印へ書きかけた「工程の効果」という言葉を見た。
「そこを分けて決めたいです。手順全体を変えたら、温度だけの効果とは言えません。まず、今回の工程表で区別した条件のうち、何ならほかをそろえて比較できるかを相談したいです」
「同じ膜を何回か測ることと、同じ条件で膜を作り直すことも、分けて記録したいですね」
大学院生は、一つの箱の下に、小さな膜を二枚描いた。
「作り方による違いを見たいなら、作製ごとのばらつきも気になります。測定値が二つあっても、それだけでは、二枚の膜を作ったことにはなりません」
第2章で文献の数字に対して考えた区別が、これから作るデータの話になった。
遥は、図へ試料と測定を結び付ける欄を加えた。
「この四つの箱が埋まれば、未知の構造への予測も確かめられますか」
先輩に聞かれ、遥は答えを急がなかった。
「その構造をモデル構築に使っていたかによります。すでに使った高分子で工程差を調べることと、未使用の構造を予測する評価は、別の問いです。実験を相談するときにも、どちらを確かめるためかを書きます」
今週、新しい膜ができるわけではなかった。
それでも、作ってほしい材料の名前を渡す前に、何を比べたいのかを相談できた。
大学院生は、余白の多い図を見て言った。
「このくらいの段階なら、比較の仕方から一緒に考えられますね」
席へ戻る途中、先輩が、秋の国内学会の案内を見ていた。
「もう少し検討を進めたら、外の人にも聞いてもらえる形にしたいですね」
遥は、自分の結果の表を思い出した。
「まだ、どうすればよくなるかは、決まっていません」
「では、どこでよくなって、どの条件では同じようによくならなかったかは?」
「それなら、今回調べた範囲で説明できます」
すぐに発表へ申し込むと決まったわけではない。けれど、外で話せるのは、成功した一枚の図だけではないのかもしれないと思った。
遥は、今度の整理を保存した。
original_paper_mapping_v01.csv。
process_paper_coverage_v01.csv。
paper_structure_splits_v01.csv。
paper_structure_predictions_v01.csv。
前の 44 行の比較結果は、上書きしていない。各回にどの記録を評価し、何を学習から外したかを、新しい予測に結び付けた。
slack には、今週確かめたことを短く書いた。
44 個の報告結果について、工程条件と元の報告論文の対応を確認しました。一部の工程の組み合わせは、少数の原著論文に偏っていました。
原著論文を一報ずつ評価側へ残し、同じ構造の記録も学習側から外す点検を、同じ二つの入力方法で行いました。
この条件での MAE は、元の入力が 0.35、工程別の入力が 0.36 でした。前の構造分割で見えた全体の改善は、同様には確認できていません。
文献に共通する事情だけが原因と決まったわけではなく、学習に使える記録の違いも含む結果です。
次は、追加で確かめたい構造と工程の組み合わせ、比較に必要な記録項目を整理し、文献で補える範囲と実験で確認したい範囲を相談します。
送信してから、遥は、最初に色を付けた散布図を開いた。
同じ色の近傍は、もう、ただ疑わしい点の集まりには見えなかった。
今の予測を支えている、具体的な報告だった。
その報告を離れても使えるのか。
使うためには、何を追加で確かめればよいのか。
色を分けたことで、次に知りたい場所も見えた。
遥は、P01 だけで埋まっていた工程の欄の横に、小さな空欄を描いた。
前なら、空欄は埋め忘れたところに見えた。
今日は、これから調べる理由のある場所だった。
そこへ、まだない数字を想像で入れる代わりに、一つの問いを書いた。
この工程を、別の材料と別の記録でも確かめるには、何が必要か。
モデルを変える前に、次に集めたい情報を、自分で選び始めていた。
===
続きはこちら