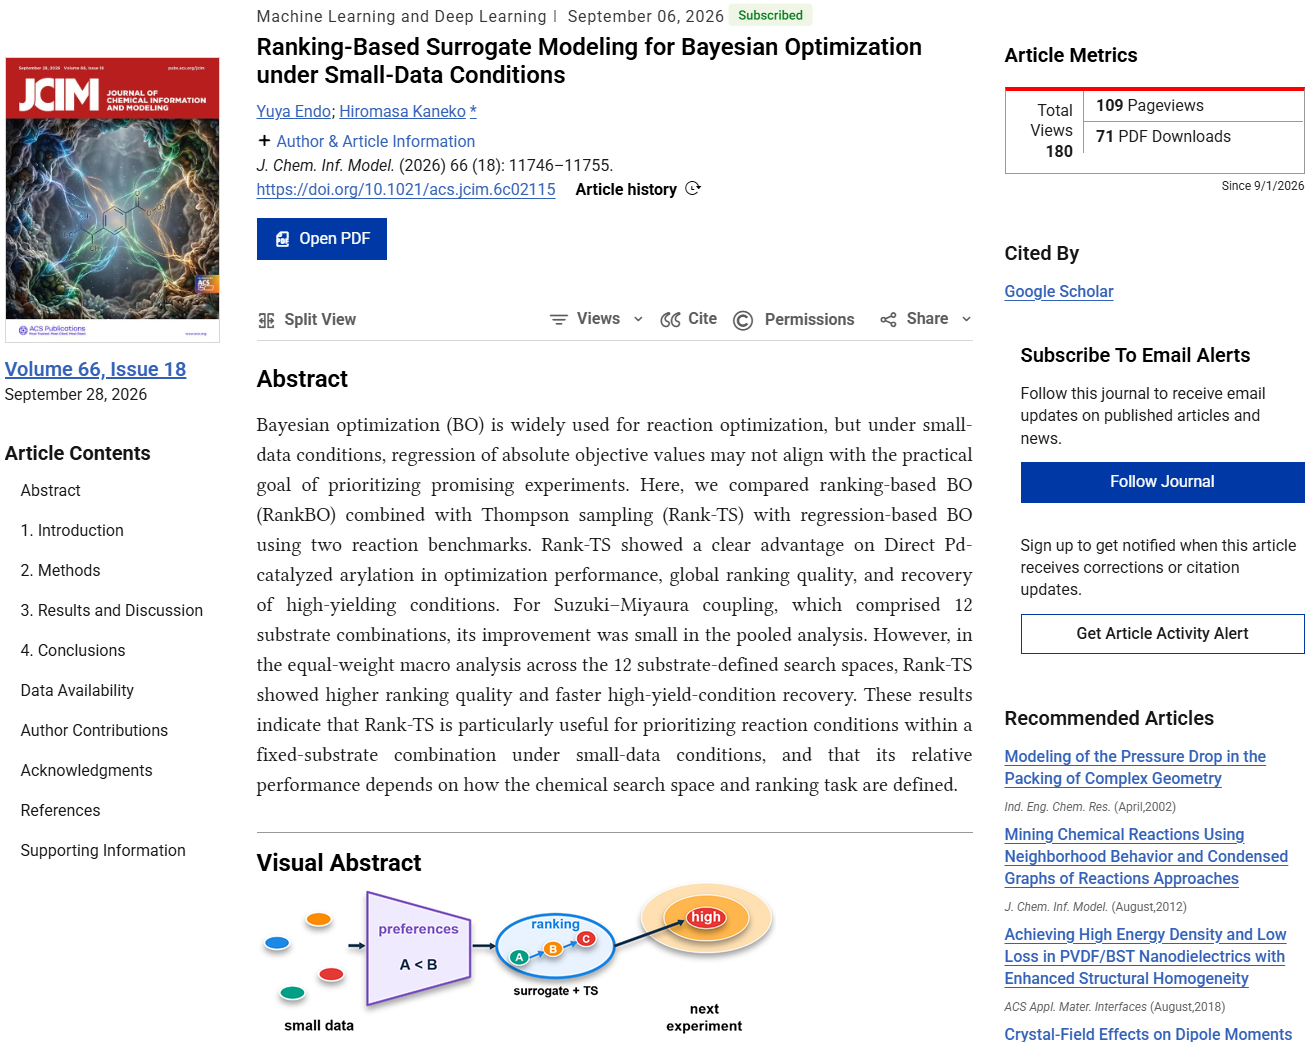
金子研の研究成果の論文が Journal of Chemical Information and Modeling に掲載されましたので、ご紹介します。タイトルは
Ranking-Based Surrogate Modeling for Bayesian Optimization under Small-Data Conditions
です。これは社会人ドクターの遠藤雄也さんが取り組んだ研究の成果です。
本研究では、反応条件の「順位」を学習するベイズ最適化により、実験データが少ない段階から高収率の条件を効率よく探索できることを示しました。
化学反応の最適化では、触媒、配位子、塩基、溶媒、温度などの膨大な組合せから、限られた実験回数で有望な条件を見つける必要があります。従来のベイズ最適化では収率の数値を予測する回帰モデルを利用しますが、データが少ない研究初期には十分な予測精度を得ることが難しく、次に試すべき条件を適切に選べるとは限りません。そこで本研究では、観測済みの反応条件を2つずつ比較し、どちらの収率が高いかという相対的な情報から条件の有望さを学ぶ順位ベースのベイズ最適化「RankBO」に着目しました。特に、ガウス過程による順位学習と、モデルの不確かさを反映して候補を選ぶトンプソンサンプリングを組み合わせた「Rank-TS」を評価しました。
検証には、パラジウム触媒による直接アリール化の1,728条件と、鈴木–宮浦カップリングの4,608条件の公開実験データを用いました。収率30%以下の20条件を初期データとし、1ラウンドに5条件を選ぶ20ラウンドの逐次探索を、初期条件を変えて100回ずつ実施しました。各試行の初期条件は、すべての手法で共通としました。その結果、Rank-TSは両反応系で探索初期から高い性能を示しました。直接アリール化では、各試行で得られた最高収率の平均が上位0.5%相当の水準に到達するまでの探索ラウンド数が、期待改善量を用いる従来の回帰型手法の18回に対して9回となりました。同じトンプソンサンプリングを用いる回帰型手法では13回を要しており、候補選択の仕組みだけでなく、順位を学習するモデルの有効性が示唆されました。鈴木–宮浦カップリングでも、改善幅は小さいものの、探索効率と試行間のばらつきを考慮した指標で、比較手法中の最良の値を得ました。また、探索途中で回帰型手法へ切り替えても一貫した改善は得られず、今回の評価範囲ではRank-TSを継続して用いる有用性が支持されました。
本研究は、実験候補の優先順位を学ぶことが、少数データ下での効率的な反応探索につながることを示しています。高精度な収率予測モデルの構築が難しい状況でも有望な条件へ早く到達できる可能性を示し、限られた時間、試薬、実験機会を有効に使う反応開発への貢献が期待されます。
興味のある方は、ぜひ論文をご覧いただければと思います。どうぞよろしくお願いいたします。
以上です。
質問やコメントなどありましたら、X, facebook, メールなどでご連絡いただけるとうれしいです。